2025年にOpenAI Trainをマスターするための決定版ガイドで、人工知能の未来を切り拓きましょう。今日の世界では、AIがビジネス、教育、そして日常生活を驚異的なスピードで変革しています。
時代の先を行くためには、体系化された最新のトレーニングにアクセスできることが不可欠です。そこで、実践的なフレームワークと専門家の知見を提供する「OpenAI Train」が、あなたの競争優位性となるのです。
このハンドブックには、実践可能な戦略、ベストプラクティス、そして最新のツールが掲載されています。このガイドを、AIスキルを磨き、明日のチャンスに備えるための不可欠なロードマップとしてご活用ください。
基礎、高度なテクニック、そして将来のトレンドを網羅したステップバイステップのアプローチで、今すぐ始めましょう。
OpenAI Trainの理解:基礎と主要概念
OpenAI Trainの世界を深く理解するには、その起源、使命、専門用語、そして世界のAI業界に与える影響をしっかりと把握する必要があります。このセクションでは、OpenAI Trainを他と一線を画す基礎的な要素を解説し、その本質を詳しく解説します。
OpenAI Trainの変遷
OpenAI Trainは、高度な人工知能トレーニングへのアクセスを民主化したいというニーズから生まれました。その歩みは、機械学習の急速な進歩への対応として始まり、瞬く間にAIエコシステムにおける主要なプレイヤーとしての地位を確立しました。
主なマイルストーンは以下の通りです:
- 最初のオープンソースプラットフォームのリリース
- 主要なAIフレームワークとの統合
- クラウドベースの共同トレーニングの導入
他のAIトレーニングプラットフォームと比較して、OpenAI Trainはその柔軟性と拡張性において際立っています。その進化は、誰もが利用でき、コミュニティ主導のAIイノベーションへの広範な潮流を反映しています。
基本理念と目標
OpenAI Trainの中心的な使命は、専門家や組織に対し、利用しやすく、倫理的かつスケーラブルなAIツールを提供することです。その中心となる原則は以下の通りです:
- アクセシビリティ:個人やチームがAIを活用する際の障壁を低減すること。
- 拡張性:スタートアップから大企業まで、あらゆる規模のプロジェクトに対応すること。
- 倫理的なAI:責任ある開発と導入を推進すること。
OpenAI Trainにはオープンソースによる協業が深く根付いており、知識の共有と迅速なイノベーションを促進しています。これらの目標に焦点を当てることで、このプラットフォームはユーザーが堅牢で将来を見据えたAIソリューションを構築できることを保証します。
重要な用語とフレームワーク
OpenAI Trainを理解するには、以下の主要な技術用語に精通する必要があります:
- モデル:データから学習して予測を行うアルゴリズム。
- データセット:トレーニングに使用される、構造化されたデータの集合。
- 微調整(Fine-tuning):特定のタスクに合わせて事前学習済みのモデルを調整すること。
- 強化学習:報酬に基づくフィードバックを通じてモデルを学習させること。
このプラットフォームは、PyTorchやTensorFlowなどの主要なフレームワークに対応しています。これらの用語を理解することは極めて重要です。なぜなら、これらがOpenAI Train内でのプロジェクトやワークフローの構築方法に影響を与え、トレーニングの効率化と再現性を高めるからです。
現在の利用統計と導入率
AIの専門知識に対する需要の高まりを反映して、近年OpenAI Trainの導入が急増しています。2024年および2025年初頭の利用統計によると、テクノロジー、医療、金融、教育などの業界で著しい普及が見られます。
主要企業は、ワークフローにOpenAI Trainを導入することの主なメリットとして、生産性の向上とイノベーションサイクルの短縮を挙げています。
OpenAI Trainと従来のAIトレーニング手法の比較
従来のAIトレーニングでは、多くの場合、オンプレミスのリソースを大量に必要とし、手作業によるプロセスも不可欠でした。OpenAI Trainでは、以下の点が導入されています:
| 機能 | 従来のトレーニング | OpenAI Train |
|---|---|---|
| デプロイ | ローカル/オンプレミス | クラウドベース |
| コラボレーション | 制限あり | リアルタイム、マルチユーザー |
| 拡張性 | 固定 | 動的 |
| 速度 | 低速 | 高速化 |
OpenAI Trainへの移行を進めている組織では、プロジェクトの納期短縮やチーム間のより効果的な連携が報告されています。クラウドおよびコラボレーション環境への移行により、企業や研究者がAIトレーニングに取り組む方法は一新されました。
OpenAI Trainの設定:ステップバイステップガイド
OpenAI Trainの導入は、綿密に計画されたセットアップから始まります。スムーズなインストールと設定プロセスは、効果的なAIトレーニング、コラボレーション、そしてスケーラブルな成果を実現するための基盤となります。以下に、環境を最適化し、成功を確実にするためのステップバイステップガイドをご紹介します。
ステップ1:前提条件とシステム要件
OpenAI Trainをインストールする前に、ハードウェアおよびソフトウェアの前提条件を確認してください。個人ユーザーの場合、最新のCPU、16GBのRAM、および最新のGPU(NVIDIA RTXシリーズを推奨)があれば、スムーズな操作が可能です。組織の場合は、スケーラブルなワークロードに対応するため、マルチGPUサーバーまたはクラウドベースのGPUインスタンスを検討してください。
対応OSには、Windows、macOS、および各種Linuxディストリビューションが含まれます。AWS、Google Cloud、Azureなどの主要なクラウドプラットフォームとも完全に互換性があり、柔軟な導入が可能です。
| 構成 | 最小要件 | 推奨 |
|---|---|---|
| RAM | 8GB | 32GB以上 |
| GPU | GTX 1060 | RTX 3080 以上 |
| ストレージ | 100GB SSD | 1TB NVMe SSD |
AIの概念に初めて触れる方や、セットアップ前に基礎知識を身につけたい方には、「初心者向けAI基礎ブートキャンプ」が、OpenAI Trainユーザー向けにカスタマイズされた必須のリソースを提供しています。
ステップ2:インストールと初期設定
公式リポジトリまたは組織内のポータルからOpenAI Trainをダウンロードしてください。お使いのシステムに適したバージョンを選択し、既存のフレームワークとの互換性を確認してください。
ローカルにインストールする場合は、次のコマンドを使用してください:
pip install openai-train
クラウド環境では、プラットフォーム固有のセットアップガイドに従ってください。インストール後、ドキュメントに記載されている通りに環境変数と依存関係を設定してください。一般的な変数には、OPENAI_TRAIN_HOMEやDATASET_PATH などがあります。
必要な Python パッケージがすべてインストールされていることを確認してください。依存関係を確認するには、`pip freeze` を使用してください。エンタープライズ環境では、Docker によるコンテナ化や Kubernetes によるオーケストレーションを行うことで、OpenAI Train のデプロイとスケーリングを効率化できます。
ステップ 3: データソースへの接続
OpenAI Trainは、CSV、JSON、Parquet、画像フォルダなど、さまざまなデータ形式に対応しています。クラウドストレージとの統合もシームレスに行えるため、AWS S3、Google Cloud Storage、Azure Blobに保存されたデータセットに簡単にアクセスできます。
データを安全に扱うためのベストプラクティスには、次のようなものがあります:
- 転送中および保存中の機密データセットの暗号化
- アクセス制御と監査ログの実施
- 認証情報およびAPIキーを定期的に更新する
データソースを接続するには、設定ファイルまたは環境変数を使用します。例:
import openai_train
openai_train.connect_data_source("s3://your-bucket/dataset")
この柔軟性により、OpenAI Trainは多様なデータパイプラインや組織のセキュリティポリシーに適応できます。
ステップ 4: ユーザーロールと権限の設定
共同でのAI開発は、OpenAI Trainの大きな強みです。ユーザーロールと権限を割り当てることで、プロジェクト、データセット、およびモデルへのアクセスを管理しやすくなります。
ロールベースの制御には、以下のものが含まれます:
- 管理者(Admin):設定およびリソースに対する完全な管理権限
- コントリビューター:プロジェクトの変更、モデルのトレーニング、データのアップロードが可能
- 閲覧者:結果およびダッシュボードへの読み取り専用アクセス権限
GDPRやHIPAAなどのデータプライバシー規制への準拠を確保するため、プラットフォーム内でアクセスポリシーを設定してください。例えば、機密性の高いデータセットへのアクセスを制限したり、ユーザーの操作に対する監査証跡を有効にしたりすることができます。
共同作業スペースを設定することで、チームは効率的に作業を行い、モデルを共有し、OpenAIのトレーニングプロセス全体を通じてデータの整合性を維持することができます。
ステップ 5: 最初のトレーニングプロジェクトの初期化
コード、データ、出力結果用の構造化されたディレクトリを作成して、最初のOpenAI Trainプロジェクトを開始します。プラットフォームのコマンドまたはドラッグ&ドロップインターフェースを使用して、データセットや事前学習済みモデルをインポートします。
典型的なプロジェクト構造:
/project-root
  /data
  /models
  /scripts
  /outputs
まずは、画像分類などのサンプルプロジェクトを起動することから始めましょう。ガイド付きのワークフローに従って、データセットの選択、モデルアーキテクチャの決定、および学習パラメータの設定を行ってください。
実践的な演習は不可欠です。Open ai train には、プロジェクトのセットアップを迅速化するためのテンプレートやウィザードが用意されており、初めての実験を学びの多い生産的なものにします。
よくあるセットアップ上の問題のトラブルシューティング
シンプルな設計にもかかわらず、OpenAI Trainの使用中にセットアップ上の問題に直面する場合があります。よくある問題としては、依存関係の不足、バージョンの不一致、権限エラーなどが挙げられます。
簡単なトラブルシューティングの手順:
- Pythonバージョンの互換性を確認する
- 仮想環境を使用して依存関係を分離する
- クラウドの認証情報とストレージのアクセス権限を確認する
問題が解決しない場合は、公式ドキュメントを参照するか、コミュニティフォーラムに参加するか、エンタープライズサポートチャネルを利用してください。互換性の問題を最小限に抑えるため、OpenAI Trainおよび関連ライブラリを定期的に更新してください。
セットアップ上の課題を早期に解決することで、OpenAI Train を使用した継続的な AI 開発とコラボレーションのための信頼性の高い基盤を確保できます。
効果的な OpenAI Train カリキュラムの設計
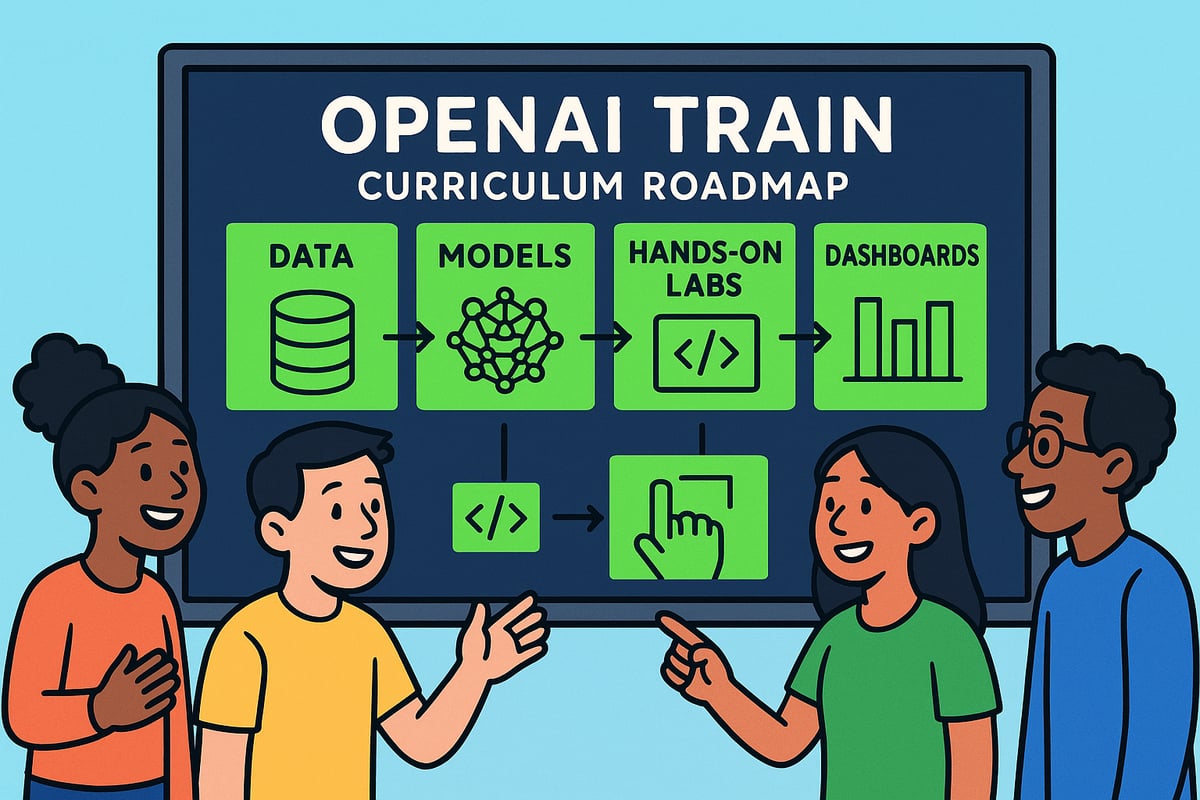
包括的なOpenAI Trainカリキュラムを構築することは、有意義な学習成果を生み出すために不可欠です。明確な目標、高品質なデータ、実践的な体験を軸にアプローチを構築することで、学習者が基礎から応用までのAIスキルを習得できるよう支援できます。 このセクションでは、カリキュラム設計プロセスを具体的な手順に分解し、OpenAI Trainプログラムが測定可能な成果をもたらすようにします。
学習目標と成果の定義
まず、OpenAI Trainカリキュラムを通じて学習者に何を達成してもらいたいかを明確にします。明確な学習目標を設定することで、従業員のスキルアップ、研究の推進、イノベーションの促進など、組織の目標に合わせて各モジュールを確実に整合させることができます。
学習目標を、測定可能な成果に細分化しましょう。例えば、参加者がモデル選択、データ前処理、あるいは性能評価において熟練したスキルを発揮できるよう目指します。研修前後の評価を活用して進捗状況を追跡し、フィードバックに基づいて必要に応じて目標を調整してください。
明確に定義されたOpenAI Trainカリキュラムは、焦点を絞った学習パスを構築し、学習者が進捗に合わせて自信と専門知識を身につけられるようにします。
データセットの選択と準備
高品質なデータセットは、あらゆるOpenAIトレーニングプログラムの基盤となります。データを選択する際は、現実世界の課題を反映できるよう、関連性、多様性、正確性を優先してください。画像分類、自然言語処理(NLP)、時系列分析など、カリキュラムで扱う具体的なタスクを考慮してください。
効果的なデータ前処理は極めて重要です。信頼性の高い学習結果を得るために、データクレンジング、正規化、データ拡張の手法を実施してください。例えば、NLP学習用の多言語テキストデータセットを準備するには、トークン化、言語検出、クラス分布のバランス調整などが必要です。
適切に準備されたデータセットにより、OpenAIのトレーニング演習は業界のシナリオを忠実に再現できるようになり、学習者の関与度と学習内容の定着率の両方を高めることができます。
適切なトレーニングモデルとアルゴリズムの選択
適切なモデルとアルゴリズムの選択は、OpenAI Trainのプロセスにおいて極めて重要です。言語タスク向けのトランスフォーマーや、画像分析向けのCNNなど、さまざまなアーキテクチャの長所とトレードオフを評価してください。
選択にあたっては、リソース消費量、精度、処理速度を考慮してください。AIを初めて学ぶ方には、『機械学習の基礎ガイド』が、OpenAI Trainのワークフローで使用されるさまざまなモデルの背後にある原理を理解するための確かな基礎を提供します。
モデルの種類やアルゴリズムの手法を比較することで、学習者は特定のタスクにおいてなぜ特定のツールが適しているのかを理解できるようになり、実世界での応用において批判的思考を養うことができます。
トレーニングモジュールとマイルストーンの構成
効果的なOpenAI Trainカリキュラムは、モジュール式で段階的に構成されています。コンテンツを、互いに連関し、段階的に構築される焦点を絞ったモジュールに分割することで、学習者が概念を段階的に習得できるようにします。
進捗を評価するために、明確なマイルストーンとチェックポイントを設定します。例えば、毎週プロジェクトベースの学習スプリントを実施し、参加者が実際のデータセットに概念を適用してフィードバックを受けられるようにします。ルーブリックや自己評価を活用して、責任感を高めます。
体系的なアプローチは、学習者のモチベーションを維持し、必須スキルの習得を確実にするとともに、技術の進化に合わせてOpenAI Trainのカリキュラムを容易に適応させることを可能にします。
実践的な実習とシミュレーションの取り入れ
体験型学習は、OpenAI Trainの学習プロセスにおいて不可欠です。理論的な概念を実践的な演習で補強するようなハンズオン実習を設計しましょう。例えば、インタラクティブなツールを用いて、リアルタイムのデータアノテーションやモデルチューニングの演習を学習者に指導します。
シミュレーションは、教室での学習と実社会での問題解決との間のギャップを埋めるのに役立ちます。理解を深めるために、各実習の後に実験、反復、振り返りを行うよう促しましょう。
実践的な体験は、OpenAI Trainをより魅力的で印象深いものにし、学習者がすぐに活用できる実践的なスキルを身につけるのに役立ちます。
インタラクティブなツールとダッシュボードの活用
最新のOpenAI Trainプラットフォームは、強力な可視化および分析機能を備えています。インタラクティブなダッシュボードを活用して、学習者のエンゲージメントを追跡し、モデルのパフォーマンスを監視し、精度や損失などのトレーニング指標の経時的な変化を可視化しましょう。
これらのツールにより、トレーナーと学習者の双方が、強みを特定し、弱点を改善し、成果を称えることが可能になります。定期的な進捗確認にダッシュボードを取り入れることで、透明性を維持し、継続的な改善の文化を育みましょう。
これらの機能を活用することで、OpenAI Trainのカリキュラムはより適応性が高く、データ駆動型となり、個々の学習者のニーズに合致したものになります。
実践的なトレーニング:ベストプラクティスと実戦的な演習
実践的な学習は、OpenAI Trainを習得する上で最も重要な要素です。理論だけにとどまらず、実践的なスキルを身につけ、理解を深め、現実世界のAI課題を解決する準備を整えることができます。このセクションでは、OpenAI Trainを最大限に活用するための重要な戦略、演習、および共同作業の手法について解説します。
トレーニング環境の準備
堅牢な環境は、効果的なOpenAI Trainセッションの基盤となります。まずは、Dockerや仮想マシンを使用して、再現可能な環境をセットアップすることから始めましょう。このアプローチにより、チームメンバー間やプロジェクトの反復プロセス全体を通じて一貫性が確保されます。
バージョン管理は極めて重要です。Gitなどのプラットフォームを使用して、コードやデータセットの変更を追跡しましょう。この慣行は、特に共同作業の場面において、プロジェクトの整合性を維持するのに役立ちます。
これらの概念に不慣れな方のために、「データエンジニアリングと機械学習マスタークラス」では、OpenAI Trainにおける環境設定やデータワークフローに関する重要な知見を提供しています。これらの手順を踏むことで、トレーニングプロセスのスケーラビリティとセキュリティを確保できます。
初めてのモデルトレーニングセッションの実行
初めてのOpenAI Trainジョブを起動することは、重要な節目となります。まずはサンプルデータセットを選択し、モデルアーキテクチャを定義することから始めましょう。プラットフォームのインターフェースまたはCLIを使用して、トレーニングプロセスを開始してください。
セッションの実行中は、リソースの使用状況とログを監視してください。OpenAI Trainはリアルタイムのフィードバックを提供するため、問題を早期に発見し、必要に応じてパラメータを調整することができます。
例えば、ソーシャルメディアのデータを用いて感情分析モデルを学習させることができます。出力結果を検証し、入力データを調整することで、学習と改善につながる即時のフィードバックを得ることができます。
モデルのパフォーマンスと精度の評価
効果的な評価は、OpenAI Trainの成功に不可欠です。主要な指標には、精度、陽性精度、再現率、F1スコアなどがあります。これらの指標は、モデルのパフォーマンスがどの程度優れているか、またどこを改善すべきかを理解するのに役立ちます。
組み込みの可視化ツールを使用して、結果を解釈しましょう。例えば、混同行列は、各クラスにわたる分類精度に関する貴重な知見を提供します。
| 指標 | 説明 |
|---|---|
| 精度 | 予測の全体的な正しさ |
| 精度 | 正の予測の正しさ |
| 再現率 | すべての陽性を検出する能力 |
| F1スコア | 精度と再現率のバランス |
一貫した評価を行うことで、OpenAI Trainプロジェクトが定義された目標を達成できるようになります。
反復的な改善とハイパーパラメータの調整
OpenAI Trainにおける最適化は継続的なプロセスです。まずは、学習率、バッチサイズ、オプティマイザーの選択といった主要なハイパーパラメータを調整することから始めましょう。
グリッド検索やベイズ最適化といった自動化ツールを使用すると、チューニングが簡素化されます。例えば、設定ファイルを使用して複数の実験を同時に実行し、結果を比較することができます。
# 例:ハイパーパラメータのグリッド検索の設定
param_grid = {
    'learning_rate': [0.001, 0.01, 0.1],
    'batch_size': [32, 64, 128]
}
反復的な微調整は、あらゆる OpenAI Train ワークフローから最大のパフォーマンスを引き出すための鍵となります。
共同トレーニングと知識の共有
OpenAI Trainは、共同作業の環境下で真価を発揮します。チームメンバーがコードを提供し、結果を確認し、知見を共有できるグループプロジェクトを設定しましょう。
ピアレビューセッションは知識の交換を促進し、ソリューションの品質を向上させます。共有ダッシュボードを活用してモデルのパフォーマンスを表示し、議論を促しましょう。
Open AI Train コミュニティ内では、オープンソースへの貢献が奨励されています。モデルを共有したり、リーダーボードに参加したりすることは、個人と組織の両方の成長を加速させます。
トレーニングにおける一般的な課題への対処
AIのトレーニングには特有の課題があります。過学習、過小学習、データの不均衡は、OpenAI Trainプロジェクトにおいて頻繁に発生する問題です。
正則化手法の適用やデータ拡張を活用することで、過学習に対処します。過小学習の場合は、より複雑なモデルや追加のデータ特徴量が必要になる場合があります。
データの不均衡については、リサンプリングやクラスの重み付けによって対処できます。これらの課題を積極的に管理することで、OpenAI Trainプロジェクトが信頼性の高い実用的な結果をもたらすことを確実にすることができます。
成功の測定:評価、認証、および継続的な改善
OpenAI Trainにおける成功の測定は、投資収益率(ROI)の最大化を目指す個人および組織にとって不可欠です。堅牢な評価、認証、および継続的改善のプロセスを活用することで、AIトレーニングの取り組みが効果的かつ適切であり続け、業界標準に準拠していることを保証できます。
明確な評価指標の確立
明確に定義された評価指標を設定することは、Open AI Train における進捗状況を追跡するために不可欠です。まず、これらの指標を当初の学習目標と整合させ、トレーニングの各段階が測定可能であることを確認することから始めましょう。
研修前後の評価といった定量的手法は、知識の習得度を測るのに役立ちます。ピアレビューやプロジェクトの成果といった定性的フィードバックは、評価プロセスに深みを与えます。包括的なアプローチのためには、「AI Fluency Assessment Resource」のようなツールを活用し、スキルをベンチマークして改善すべき領域を特定することを検討してください。
評価手法のサンプル表:
| 方法 | 目的 | 実施頻度 |
|---|---|---|
| 研修前のクイズ | 基礎知識 | 導入研修 |
| プロジェクトベースの評価 | 応用スキル | 隔週 |
| ピアレビュー | 協働による改善 | 月次 |
| AI活用能力評価 | 業界との連携 | 四半期ごと |
OpenAIのトレーニング・評価指標を定期的に活用することで、チームや個人は自身の強みを特定し、課題を効率的に解決することができます。
認定および資格取得の選択肢
OpenAI Trainを通じて認定資格を取得することは、専門知識の具体的な証明となり、キャリアの展望を広げます。広く認められた資格は、雇用主や同僚に対してあなたのスキルを証明し、プロフェッショナルとしての評価を高めます。
認定を受けたAI専門家に対する業界の需要が高まっており、認定取得は重要なマイルストーンとなっています。一般的な取得経路としては、基礎認定、上級専門認定、および役割別認定などがあります。注目すべき事例として、OpenAI Trainの認定を取得した後、医療分野におけるAIを活用したプロジェクトを率いる立場へと昇進を果たした専門家が挙げられます。
OpenAI Train認定資格のメリットには、次のようなものがあります:
- 実証可能なスキルの証明
- 就職市場における競争力の向上
- 高度なトレーニングリソースへのアクセス
適切な認定資格の取得コースを選択することで、学習内容が常に実務に即したものであり続け、長期的な目標の達成を後押しします。
フィードバックループとカリキュラムの継続的な更新
継続的な改善は、OpenAI Trainの哲学の中核をなしています。学習者やステークホルダーからの意見を収集する効果的なフィードバックループが、カリキュラムの反復的な改善を推進しています。
トレーニングの効果を評価するために、定期的な見直しサイクルを導入します。定量データ(評価スコアなど)と定性的なフィードバック(学習者満足度調査など)の両方を収集します。これらの知見を基にカリキュラムを更新することで、業界のニーズの変化にカリキュラムが適応するよう確保します。
カリキュラム改善のプロセス例:
- 研修終了後にフィードバックを収集する。
- 結果を分析し、傾向を把握する。
- モジュールや教材を更新する。
- 変更内容をすべての利用者に周知する。
このアプローチにより、Open AI Trainは、すべての参加者にとって、機敏で、関連性が高く、影響力のあるプログラムであり続けることができます。
業界標準とのベンチマーク
Open AI Trainの成果を業界標準と照らし合わせて評価することは、競争力を維持するために不可欠です。学習者の成果を、グローバルな評価スコアやAIコンテストでの成績など、広く認められているベンチマークと比較してください。
Kaggleのような外部のチャレンジに参加することで、スキルレベルに関する貴重な知見が得られ、成長すべき分野が明確になります。より広い文脈で捉えるには、『2025年の生成AI導入状況』を参照することで、各セクターにおけるAIトレーニングの成果がどのように進化しているかがわかります。
比較表には、以下のような項目を含めることができます:
| 標準 | OpenAIのトレーニング平均 | 業界ベンチマーク |
|---|---|---|
| 認定試験合格率 | 85% | 80% |
| プロジェクト完了率 | 90% | 88% |
| コンテスト順位 | 上位10% | 上位15% |
定期的なベンチマーク調査を行うことで、OpenAIのトレーニングに関する取り組みがベストプラクティスや市場の期待に沿ったものであることを確認できます。
生涯学習とスキルアップの支援
OpenAI Trainでの成長を持続させるには、生涯学習への継続的な取り組みが不可欠です。継続的な教育パスを統合し、専門家が初心者向けモジュールからエキスパート向けモジュールへとシームレスに移行できるようにしましょう。
上級コース、メンターシッププログラム、業界イベントへの参加機会などのリソースを提供します。フォーラム、ウェビナー、研究コミュニティへの参加を奨励し、スキルを常に研ぎ澄ませるよう促します。
OpenAI Trainにおける典型的なキャリアパスは、次のようなものになるでしょう:
- 基礎モジュールを修了する
- 認定資格の取得
- 高度な専門分野に取り組む
- 共同プロジェクトに参加する
- 新規学習者のメンターを務める
継続的なスキルアップの文化を育むことで、組織や個人は、進化し続けるOpenAI Trainの世界において、持続的な成功を確実に手に入れることができます。
AIスキルの将来性確保:2025年以降のトレンドと予測
2025年が近づくにつれ、人工知能の分野は急速に進化しています。競争力を維持するためには、専門家はOpenAIトレーニング戦略を絶えず適応させていく必要があります。このセクションでは、今後数年間で個人や組織がOpenAIトレーニングに取り組む姿勢を形作る、最新のトレンド、新たな手法、そして将来の予測について考察します。
新興技術と手法
OpenAIトレーニングの次の波は、生成AI、フェデレーテッドラーニング、エッジコンピューティングとの統合によって特徴づけられるでしょう。これらの進歩により、より高速で、より安全、かつ高度にパーソナライズされたトレーニング体験が可能になります。例えば、フェデレーテッドラーニングにより、組織は分散型データソースを横断してモデルをトレーニングすることができ、プライバシーとコンプライアンスが強化されます。
強化学習もまた画期的な技術であり、AIエージェントが試行錯誤を通じて複雑なタスクを学習できるようにします。「Agent Lightning: Train ANY AI Agents with Reinforcement Learning」フレームワークは注目すべき開発であり、高度なOpenAI Trainワークフローに柔軟性をもたらします。これらの技術が成熟するにつれ、より適応性が高く自律的なトレーニング環境が登場することが期待されます。
倫理と責任あるAIの役割
倫理的配慮は、今やOpenAI Trainの中心的な課題となっています。AIシステムが生活のより多くの側面に影響を及ぼすにつれ、透明性、公平性、説明責任を優先しなければなりません。2025年には、組織がモデル開発におけるバイアスを検知・軽減するための堅牢なフレームワークを導入することが期待されています。
説明可能なAI(Explainable AI)は標準となりつつあり、ステークホルダーがモデルの意思決定を理解できるようになっています。GDPRのような規制や、新たに策定されつつあるAI特有の基準により、OpenAI Trainプログラムでは、データソース、学習プロセス、および結果を文書化することが求められています。責任あるAIの実践は、信頼を築くだけでなく、変化し続ける規制環境におけるコンプライアンスの確保にもつながります。
世界のAI人材の現状と機会
OpenAI Trainの専門知識を持つ熟練したプロフェッショナルへの需要は、2030年にかけて急増すると予測されています。リモートワーク、国境を越えたコラボレーション、そして地域ごとのAIハブの台頭により、多様な機会が生まれています。アジア、ヨーロッパ、北米ではAI教育に多額の投資が行われており、新たな卓越した研究拠点の出現につながっています。
個人にとっては、これはキャリアパスの拡大や、グローバルなプロジェクトに参加する機会の増加を意味します。継続的な学習と国際的なパートナーシップを促進する組織は、競争優位性を維持し続けるでしょう。OpenAI Trainのスキルは現在、テクノロジー、医療、金融、さらにはその他の分野における職務に不可欠なものとして認識されています。
持続可能なAI学習エコシステムの構築
堅牢なエコシステムは、OpenAI Trainの長期的な成功にとって不可欠です。学術界、産業界、オープンソースコミュニティ間の連携が、イノベーションとアクセスの促進につながります。官民からの資金提供は、研究、カリキュラム開発、および人材のスキルアップを支援します。
AIトレーニングデータセット市場の規模や統計の急速な拡大は、トレーニングにおける高品質なデータの重要性を浮き彫りにしています。持続可能な取り組みには、オープンなデータ共有、倫理的なデータ収集、教育成果の継続的な評価などが含まれます。官民パートナーシップのような取り組みは、包摂的で拡張性のあるAI学習環境への道を切り開いています。
最先端を走り続けるために:おすすめの資料とコミュニティ
オープンAIトレーニングの時代で成功を収めるためには、主要なフォーラム、カンファレンス、オンラインコミュニティへの参加が不可欠です。AI Stack Exchange、専門のSlackグループ、年次サミットなどのプラットフォームを通じて、最新の研究情報や仲間からのサポートを得ることができます。
厳選されたブログ、ニュースレター、ポッドキャストを通じて、影響力のあるオピニオンリーダーをフォローすることを検討してください。コンテストや共同プロジェクトへの参加は、スキル向上を加速させます。これらのリソースを活用することで、OpenAI Trainに関する知識を常に最新の状態に保ち、将来にわたって通用するスキルを身につけることができます。
このガイドで見てきたように、OpenAI Trainを習得することは、単に新しいツールを学ぶこと以上の意味があります。それは、キャリアの将来性を確保し、急速に進化するAIの分野で先頭を走り続けることなのです。効果的なカリキュラムの設計を目指している場合でも、実社会向けのAIソリューションの実装を目指している場合でも、強固な基礎を築くことが不可欠です。 次のステップに進み、自身のスキルを認められる準備ができているなら、今日からその旅を始めてみませんか?認定AI Foundation Specialistになりましょう。無料で始められます。認定AI Foundation Specialistになりましょう。無料で始められます。