2026年、人工知能(AI)の専門知識に対する需要はかつてない水準に達し、あらゆる業界の組織がAIを業務に組み込むべく競い合っています。テクノロジーの状況が猛烈なスピードで進化する中、専門家にはイノベーションのペースに遅れをとらない、柔軟かつ包括的な学習ソリューションが求められています。 オンラインAI研修は、従来の教育モデルの制約を受けずに、個人やチームが最先端のスキルを習得するための主要な手段として台頭してきました。この変化は単なる利便性の問題にとどまらず、技術的知識が提供され、評価され、実社会で応用される方法における根本的な変革を反映しているのです。
オンラインAIトレーニングの現状を理解する
オンラインAIトレーニングのエコシステムは著しく成熟しており、基礎概念から、自然言語処理、コンピュータビジョン、強化学習といった高度な専門分野に至るまで、学習者にあらゆるコンテンツを提供しています。最新のプラットフォームでは、オンデマンドの動画講座、インタラクティブなコーディング環境、ライブ形式のブートキャンプ、ピアレビューによるプロジェクト評価など、多様な形式を通じてコンテンツが提供されています。
効果的なオンラインAIトレーニングの主要要素
質の高いAIトレーニングプログラムには、表面的な概要説明と、真に変革をもたらす学習体験とを区別する、いくつかの特徴があります:
- モデルの構築、学習、デプロイを必要とする実践的な実装プロジェクト
- TensorFlow、PyTorch、あるいは専門的なツールに踏み込む前に、フレームワークに依存しない基礎を習得する
- 「おもちゃのような問題」ではなく、実際のデータセットやビジネスシナリオを用いた演習
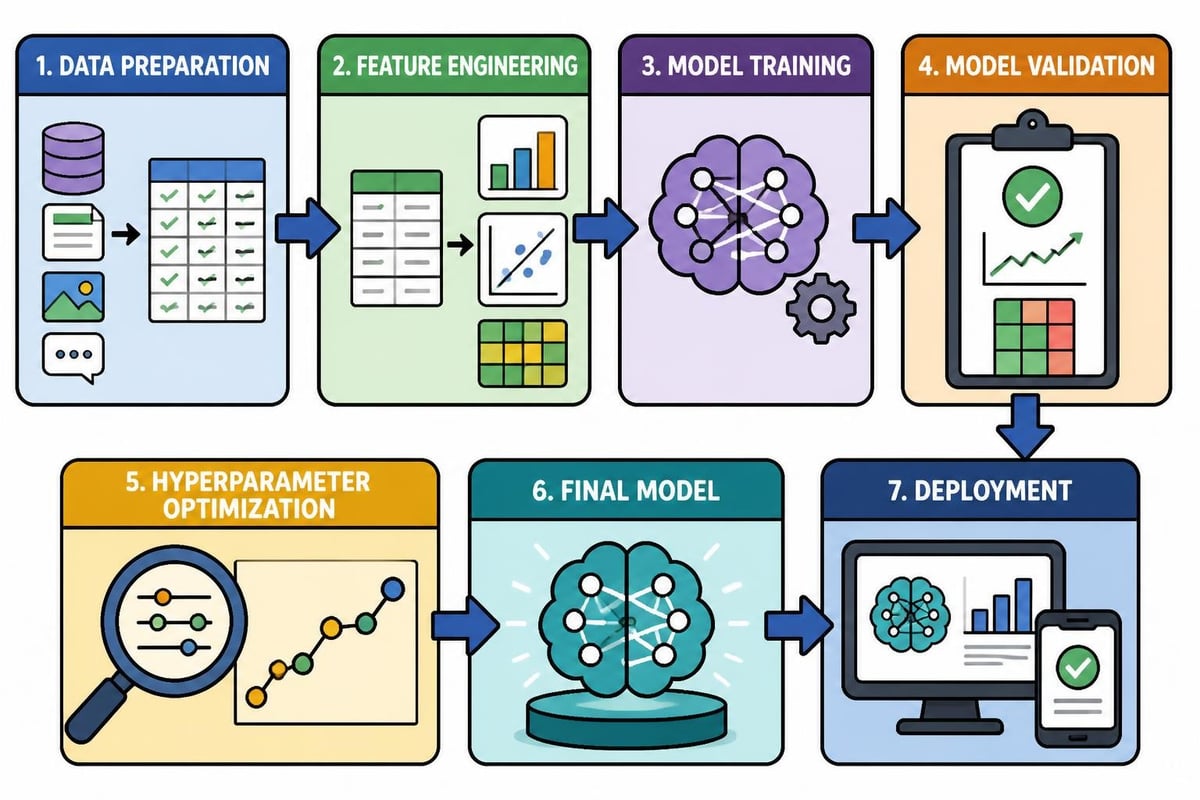
- ハイパーパラメータの調整や分散トレーニングを含む、パフォーマンス最適化の手法
- 倫理的配慮と責任あるAI開発の実践
優れたプログラムは、理論的な知識だけでは不十分であることを認識しています。学習者は、実際のトレーニングワークフローに取り組み、モデルのパフォーマンスのデバッグを行い、さまざまなアーキテクチャの選択に内在する計算上のトレードオフを理解しなければなりません。
コースの種類と学習パスの区別
すべてのオンラインAIトレーニングが、同じ目的や対象者を想定しているわけではありません。分類体系を理解することで、学習者は自分の目標に合ったプログラムを選択できるようになります:
| コースの種類 | 期間 | 適している対象 | 主な成果 |
|---|---|---|---|
| 基礎編 | 4~8週間 | 初心者、転職希望者 | 機械学習の基礎概念、Pythonの習熟度 |
| 専門コース | 8~16週間 | 現役開発者 | NLP、CV、またはRLにおける実運用レベルのスキル |
| 認定プログラム | 3~6ヶ月 | 企業チーム、キャリアアップ | ベンダー固有の資格、エンタープライズ環境での導入 |
| ブートキャンプ | 12~24週間 | 集中的なスキル習得 | ポートフォリオプロジェクト、就職支援 |
教育・学習戦略にAIを導入している組織は、スキルアップ施策を設計する際、こうした違いを理解しておくことが有益です。従業員の経験レベルとコース構成の適切なマッチングこそが、ブランド名の認知度よりもはるかにプログラムの成功を左右するのです。
適切なAIトレーニングプラットフォームとカリキュラムの選定
オンラインのAI研修には選択肢が豊富にあるため、それはチャンスであると同時に混乱の原因にもなります。意思決定者は、投資が測定可能な成果をもたらすことを確実にするために、多角的な観点からプラットフォームを評価する必要があります。
技術的な深さとフレームワークの網羅性
本格的なAIトレーニングには、業界標準のフレームワークやツールを活用することが不可欠です。実装を伴わない概念的な理解のみに重点を置いたプログラムでは、学習者は実践的な課題に対応できる準備が整いません。TensorFlowの公式チュートリアルや PyTorchのドキュメントは、質の高いコースが参照し、その内容を基盤として構築すべき、包括的で信頼性の高いリソースを提供しています。
主要なプラットフォームでは、これらのフレームワークを通じて体系的な学習パスを提供しており、基本的なテンソル演算から始まり、カスタムトレーニングループ、混合精度トレーニング、モデルの量子化といった高度なトピックへと進んでいきます。この段階的な学習プロセスは重要です。バックプロパゲーションの仕組みを理解せずにトランスフォーマーアーキテクチャに直接飛びついてしまうと、トラブルシューティングの際に知識の欠落が露呈することになります。
企業研修と個人学習の比較
チーム向けにオンラインのAIトレーニングを購入する組織は、個人の学習者とは異なる要件に直面します。企業向けプログラムには以下が必要です:
- 進捗状況を詳細に追跡・報告できる学習管理システム
- 特定のビジネスユースケースに合わせたカスタマイズ可能なコンテンツ
- 多様な技術的バックグラウンドに対応した多段階のカリキュラム
- スキルの習得を証明し、研修投資の正当性を裏付ける認定コース
MammothClubの法人向けプログラムのようなビジネスプラットフォームは、AIを活用したダッシュボードを通じて、参加者のエンゲージメントパターン、知識のギャップ、推奨される対策を可視化することで、こうしたニーズに対応しています。このデータ駆動型のアプローチにより、研修は単なるコンプライアンス上の「チェック項目」から、戦略的な能力構築の取り組みへと変革されます。
個々の学習者は、それぞれ異なる要素を重視します:
- 自分のペースで学習し、難しい概念を繰り返し復習できる柔軟性
- 仲間からのサポートや協働による問題解決のためのコミュニティへのアクセス
- 履歴書の添削や面接対策を含むキャリア支援
- 従来の学位プログラムやブートキャンプと比較した費用対効果
優れたAIコースは、こうした相反する優先事項のバランスを取り、オンライン学習の魅力である自主性を損なうことなく、体系的な指導を提供しています。
高度なトレーニング手法と専門分野
AIの能力が拡大するにつれ、オンラインAIトレーニングは、一般的な機械学習の枠を超え、特定の業界の課題や技術的な最前線に取り組む、高度に専門化された分野へと進化しています。
自然言語処理と大規模言語モデル
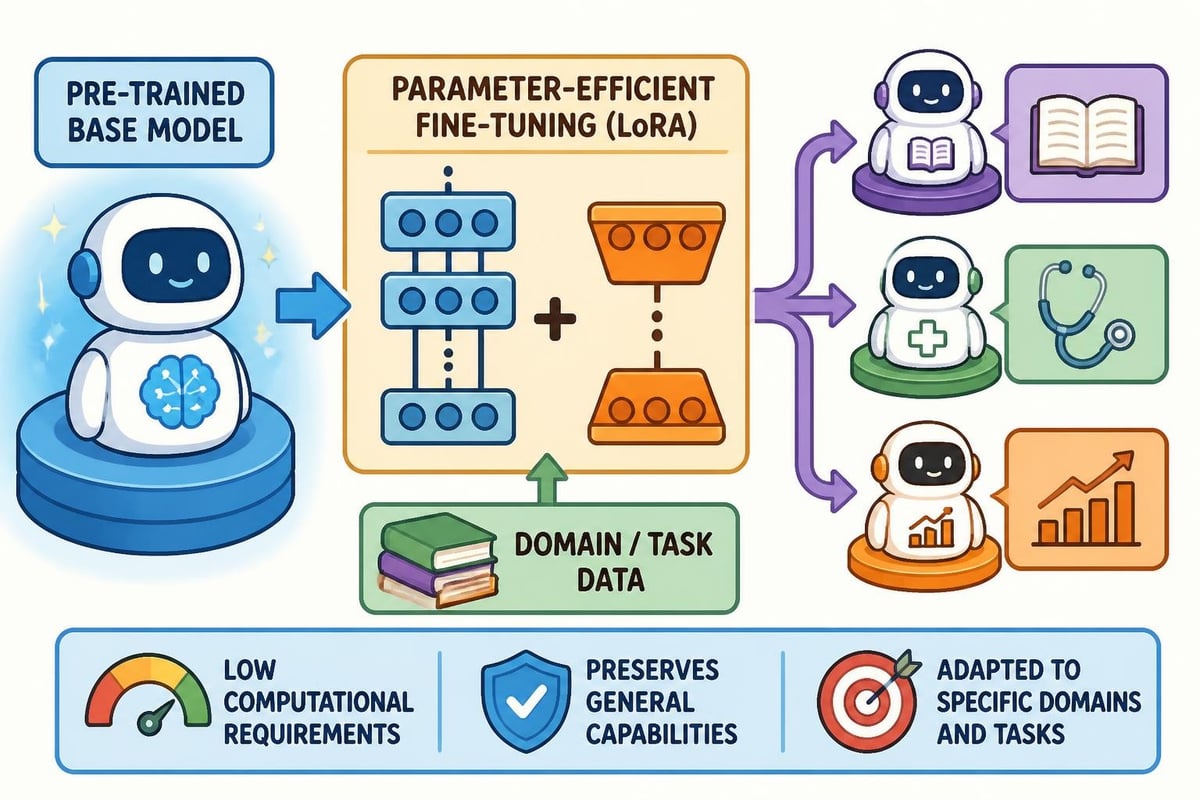
生成AIの爆発的な普及により、NLPの専門知識に対する需要が急増しています。 現代のトレーニングプログラムでは、LoRA(Low-Rank Adaptation)のようなパラメータ効率に優れた手法を含め、大規模言語モデル(LLM)の微調整技術が組み込まれています。LoRAに関する研究論文では、実務者が一般向けのハードウェアを使用して数十億パラメータのモデルを適応させることを可能にするアプローチが紹介されており、これはLLMのカスタマイズを広く普及させた画期的な進歩です。
効果的なオンラインNLPトレーニングでは、以下の内容を扱います:
- アテンションメカニズムや位置エンコーディングを含むトランスフォーマーアーキテクチャの基礎
- ラベル付きデータが限られている状況でのドメイン適応に向けた転移学習戦略
- ファインチューニングを行わずにモデルの性能を最大化するプロンプトエンジニアリングの手法
- ベクトルデータベースと言語モデルを組み合わせたリトリーバル拡張生成
これらのトピックを習得するには、API、埋め込みモデル、オーケストレーションフレームワークを用いた実践的な実験が必要です。単に動画を視聴するだけでは不十分であり、学習者はトークン化の問題をデバッグし、推論コストを最適化し、ビジネス要件に基づいてモデル出力を評価する必要があります。
コンピュータビジョンとマルチモーダル学習
コンピュータビジョンは、医療画像から自律システムに至るまで、AIアプリケーションの礎であり続けています。この分野における質の高いオンラインAIトレーニングは、基礎から最先端のアーキテクチャまでを網羅しています。スタンフォード大学のCS231nコースは、厳密な理論的基礎を提供しており、オンラインプラットフォームでは、実践的な実装プロジェクトを通じてその内容をさらに深めています。
現代のビジョン学習では、以下の点が取り上げられています:
| トピック分野 | 主要な概念 | 実践的な応用 |
|---|---|---|
| 物体検出 | YOLO、R-CNNファミリー、アンカーフリー手法 | 小売分析、監視、ロボティクス |
| セグメンテーション | U-Net、Mask R-CNN、トランスフォーマー | 医療画像、自動運転車 |
| マルチモーダル | CLIP、ビジョン・言語モデル | コンテンツモデレーション、画像生成 |
| 3Dビジョン | NeRF、点群、メッシュ処理 | AR/VR、産業用検査 |
学習者は、ビジョンタスクにおけるデータ前処理やデータ拡張の重要性を過小評価しがちです。クラスの不均衡、ドメインシフト、エッジケースに対処できる堅牢なトレーニングパイプラインを構築する方法を理解しているかどうかが、単なる愛好家と、本番システムを展開できる実務家を分けるのです。
分散学習とインフラの最適化
モデルの規模が大きくなるにつれ、トレーニングの効率は競争上の優位性となります。現在、高度なAIトレーニングのオンラインプログラムには、以前は研究機関に限定されていた分散トレーニングの概念が組み込まれています。マイクロソフトの分散トレーニングに関するドキュメントでは、HorovodやDeepSpeedといったフレームワークが、複数のGPUやノードにわたるモデルトレーニングをどのように実現しているかが説明されています。
大規模なトレーニングを行うには、以下の点を理解する必要があります:
- データ並列とモデル並列のトレードオフ
- より大きなバッチサイズをシミュレートするための勾配の蓄積
- FP16またはBF16データ型を用いた混合精度学習
- フォールトトレランスと実験の再現性を確保するためのチェックポイント戦略
NVIDIA Deep Learning Instituteでは、CUDAの最適化からマルチノードスケジューリングに至るまで、GPU加速ワークフローに関する専門的なトレーニングを提供しています。独自データを用いてカスタムモデルを学習させる組織にとって、こうしたインフラストラクチャに関するスキルは、アルゴリズムの選択以上にプロジェクトの実現可能性を左右することがよくあります。
認定資格取得パスと専門能力開発
資格は、オンラインのAIトレーニングを通じて習得したスキルを第三者機関が認定するものであり、雇用主には客観的な評価基準を提供し、専門家にとってはキャリアにおける差別化要因となります。
ベンダー固有の認定資格
主要なクラウドプロバイダーやAIプラットフォームは、自社のエコシステムにおける実践的な能力を検証する認定プログラムを提供しています。「Azure AI Engineer Associate」認定は、Microsoftのクラウドサービスを使用してAIソリューションを設計・実装する能力を証明するものであり、他のベンダーのプログラムはそれぞれのプラットフォームやツールに焦点を当てています。
これらの認定資格には、通常、以下の要件が求められます:
- サービスの機能やベストプラクティスを網羅した監督付き試験に合格すること
- 実習やポートフォリオ審査を通じて実践的なスキルを実証すること
- プラットフォームの進化に伴い、継続教育を通じて資格を維持すること
ベンダー認定資格は、特定のクラウドプロバイダーを標準化している企業では重要視されますが、異種混在環境やオンプレミス環境では、その関連性が限定的となる場合があります。
フレームワークおよび方法論に関する認定資格
別の認定パスでは、プラットフォーム固有の実装よりも、汎用的なスキルに重点が置かれています。TensorFlow、PyTorch、またはMLOpsの専門知識を認定するプログラムは、多様な導入環境において適用可能な能力を証明するものです。
その価値提案には大きな違いがあります:
ベンダー認定:
- 特定の製品スイートに関する専門知識を証明する
- コンサルティングや導入業務においてしばしば求められる
- プラットフォームが機能を非推奨にすると、認定が失効する可能性がある
フレームワーク認定資格:
- 基本的な技術的スキルを証明できる
- 職種変更や技術移行の際にもその能力が活かされる
- より深い概念的理解が求められる
初心者向けのAI基盤を構築する組織では、通常、初期段階でフレームワークのスキルを重視し、ベンダー固有のトレーニングは導入プラットフォームが選定されるまで先送りします。この順序付けにより、知識の陳腐化を防ぎ、戦略的な柔軟性を維持することができます。
実践的な実装と実社会での応用
オンラインAIトレーニングの有効性を最終的に判断する基準は、その応用成果にあります。つまり、学習者はトレーニング前に解決できなかったビジネス上の課題に対して、ソリューションを成功裏に実装できるかどうかです。
実運用可能なモデルの構築
クリーンなデータセットを用いた学術的な演習は、実運用における機械学習とはほとんど似ていません。効果的なトレーニングプログラムは、現実世界における複雑な要素を取り入れることで、このギャップを埋めます:
- 堅牢な前処理パイプラインを必要とする欠損データや破損データ
- 入力の分布が変化するにつれてモデルの性能が低下する「コンセプトドリフト」
- 推論のレイテンシ要件によるモデルアーキテクチャの選択制約
- 解釈可能な予測を求めるステークホルダーからの説明可能性への要求
fast.aiの「Practical Deep Learning」コースは、理論的な純粋さよりも実用的なソリューションを優先する実践的なトレーニングの好例です。この哲学は、論文を発表するよりも製品をリリースする必要がある実務者たちの心に響きます。
データセットとベンチマークの選定
AIモデルの学習には、学習と評価の両方に適したデータセットが必要です。「Papers With Code」のデータセットリポジトリでは、関連するベースライン結果とともに数千ものベンチマークデータセットが厳選されており、学習者は自身の実装を公表済みの研究成果と比較することができます。
データセットの特性を理解することは極めて重要です:
- 問題の複雑さに対するデータセットの規模と多様性
- ラベルの品質とアノテーションに潜むバイアス
- 商用利用に影響を与えるライセンス上の制限
- 事前学習済みモデルにおけるテストセットの汚染リスク
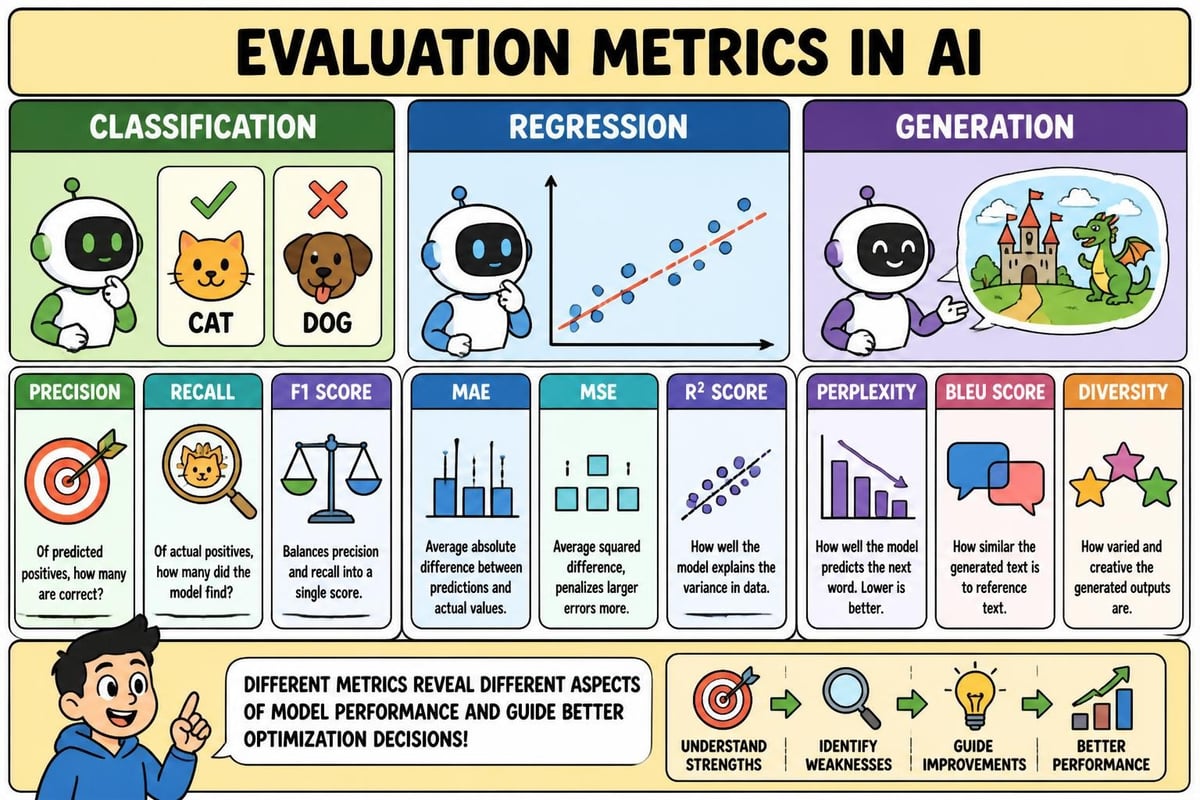
多くのオンラインAIトレーニングプログラムはデータセットの選定を軽視しており、学習者にあらかじめ用意された例を提示している。データの品質や代表性について判断力を養うことが、有能な実務家と、新たな問題に苦戦する人々との違いを生み出す。
学習効率とコストの測定
コンピューティングコストが上昇する中、トレーニング効率は経済的な必須要件となっています。MLPerfのトレーニングベンチマークは、さまざまなハードウェア構成にわたるトレーニングパフォーマンスの標準化された測定値を提供し、データに基づいたインフラストラクチャの意思決定を可能にします。
上級学習者にとっては、以下の点を理解することが役立ちます:
- 1秒あたりの処理サンプル数で測定されるトレーニングスループット
- 速度とモデルの品質のバランスを考慮した「精度到達時間」の指標
- クラウド利用料やハードウェアの償却費を考慮したトレーニング実行あたりのコスト
- 責任あるAI開発のためのカーボンフットプリントへの配慮
こうした運用上の課題は、入門コースではほとんど取り上げられることはありませんが、組織がAIイニシアチブを概念実証(PoC)から本番環境への展開へと拡大するにつれて、極めて重要になってきます。
新たなトレンドと将来を見据えたスキル
AI分野は絶えず進化しているため、適応力は現在の技術的知識と同様に重要視されています。先見性のあるオンラインAIトレーニングでは、一時的なツールの習熟度よりも、他の分野にも応用可能な問題解決アプローチを重視しています。
自動機械学習とニューラルアーキテクチャ検索
AutoMLプラットフォームは、これまで専門家の介入を必要としていたタスク――ハイパーパラメータの最適化、特徴量エンジニアリング、さらにはアーキテクチャ設計に至るまで――をますます処理するようになっています。これらのツールは、AIの専門知識を時代遅れにするのではなく、スキルの最前線をメタ学習へとシフトさせています。つまり、自動化で十分な場合と、人間の洞察が不可欠な場合を見極めることです。
現在、研修プログラムには以下の内容が含まれています:
- AutoMLプラットフォームの機能と、それらが適したユースケース
- ニューラルアーキテクチャ検索の基礎と計算リソースの配分
- 自動化されたデータ前処理とカスタムパイプライン開発の比較
- 新しいドメインへの迅速な適応を可能にするメタ学習の概念
この進化は、ソフトウェア開発における歴史的な変遷と並行しています。より高レベルの抽象化は、プログラミングの仕事そのものをなくしたわけではなく、価値ある専門知識の本質を変えたのです。
強化学習とマルチエージェントシステム
現在のAIアプリケーションでは教師あり学習が主流ですが、不確実性下での逐次的な意思決定や最適化を伴う問題においては、強化学習が最前線を担っています。オンラインの高度なAIトレーニングでは、RLの基礎がますます取り上げられるようになっています:
- マルコフ決定過程とベルマン方程式
- PPOやTRPOを含むポリシー勾配法
- DQNやその派生手法などの価値ベースのアプローチ
- 競争的および協調的なダイナミクスを伴うマルチエージェントシナリオ
これらのトピックには、一般的なデータサイエンスの知識を超える高度な数学的素養が求められますが、ロボット工学からアルゴリズム取引に至るまで、幅広い応用分野を切り拓きます。AIを活用した取引アプリケーションを検討している組織にとっては、強化学習の専門知識が特に有益です。なぜなら、強化学習はポートフォリオの最適化やリスク管理を直接モデル化できるからです。
責任あるAIと倫理的配慮
AIシステムは重大な意思決定に影響を与えるため、技術的な熟練度だけでは不十分です。包括的なトレーニングプログラムでは、倫理的枠組みをオプションのモジュールに限定するのではなく、カリキュラム全体に組み込んでいます:
- 公平なモデルを実現するためのバイアス検出および軽減手法
- 差分プライバシーやフェデレーテッドラーニングを含む、プライバシー保護型機械学習
- 規制対象業界向けのモデルの解釈可能性に関するツールと手法
- イノベーションとリスク管理のバランスをとるAIガバナンスの枠組み
これらの能力は、求人要件や認定基準にますます多く見られるようになっており、持続可能なAIの導入には、初期段階から責任ある開発慣行が不可欠であるという業界の認識を反映しています。
組織におけるAI能力の大規模な構築
個人の学習も重要ですが、組織の変革には能力開発に対する体系的なアプローチが必要であり、オンラインAIトレーニングは、一元化されたプラットフォームと標準化されたカリキュラムを通じて、これを唯一可能にします。
企業向けAIアカデミーの設計
先進的な組織では、外部の研修プロバイダーと、自社独自のシステムやビジネス環境に対応したカスタムコンテンツを融合させた社内AIアカデミーを設立しています。こうした取り組みは通常、以下の成熟度モデルに基づいて行われます:
フェーズ1:認識の醸成
- AIの能力と限界に関する経営陣向けブリーフィング
- 部門単位のワークショップによる自動化の機会の特定
- 技術的知識を持たないステークホルダー向けの基礎知識研修
フェーズ2:技術スキルの向上
- データサイエンティストおよびMLエンジニア向けの集中研修
- MLOpsの実践を学ぶソフトウェアエンジニアリングチーム
- AIプロダクトマネジメントスキルを習得するドメインエキスパート
フェーズ3:イノベーションの実現
- 新興技術における高度な専門化
- 部門横断的なAIプロジェクトチーム
- 社内での知識共有とベストプラクティスの普及
こうした取り組みを支援するプラットフォームは、戦略的な視点が必要な経営幹部から、実践的な実装スキルを必要とするエンジニアまで、多様な役割に応じた学習パスを提供します。評価の厳格さを維持しつつコンテンツをカスタマイズできる点が、エンタープライズグレードのソリューションと一般消費者向けのコースマーケットプレイスとの違いです。
研修のROIとビジネスへの影響の測定
研修への投資は、測定可能な成果を通じてその正当性を立証する必要があります。組織は、オンラインAI研修の効果を以下の複数の側面から追跡しています:
| 指標のカテゴリー | 指標の例 | 測定手法 |
|---|---|---|
| エンゲージメント | コース修了率、学習に費やした時間 | LMSの分析データ |
| 知識の習得 | 事前・事後評価の得点、認定試験の合格率 | 標準化されたテスト |
| アプリケーション | 展開されたプロジェクト、本番環境でのモデル | プロジェクト追跡システム |
| ビジネスへの影響 | プロセスの効率化、AI製品による収益 | 財務分析 |
トレーニング完了からビジネスへの影響が現れるまでのタイムラグにより、効果の帰属判断は複雑になりますが、AIプログラムが成熟した組織では、トレーニング施策の実施前にベースライン指標を設定し、その効果を明確に特定しています。
持続可能な学習文化の醸成
単発の研修では、永続的な変化をもたらすことはめったにありません。持続可能なAI能力を構築するには、日々の業務に組み込まれた継続的な学習が必要です。高いパフォーマンスを発揮する組織は、以下の取り組みを通じてこれを促進しています:
- 実務者が課題や解決策を共有する「実践コミュニティ」
- 成功事例を紹介する社内カンファレンスやデモデー
- プロジェクトのスケジュールに組み込まれた専用の学習時間
- 経験豊富な実務家と学習者をペアにするメンターシッププログラム
こうした文化的要素により、オンラインAIトレーニングは単発のイベントから、技術の変化に遅れを取らない継続的な能力開発へと変貌を遂げます。
組織におけるプラットフォーム選定基準
適切なオンラインAI研修プロバイダーの選定は、組織の能力開発に長期的な影響を及ぼす戦略的な決定である。
コンテンツの幅と深さのトレードオフ
プラットフォームによって、コンテンツ戦略には大きな違いがあります。考えられるあらゆる技術を網羅した百科事典のようなカタログを提供するプラットフォームもあれば、特定の分野に特化した学習パスを厳選して提供するプラットフォームもあります。どちらのアプローチも普遍的に優れているわけではなく、適切な選択は組織のニーズによって異なります:
幅広いプラットフォーム(3,000以上のコース):
- チーム横断的な多様な学習目標をサポート
- 専門分野を決定する前に、幅広い分野を探索できる
- 選択肢が多すぎて学習者が迷ってしまうリスクがある
- 網羅性を優先するあまり、深みが犠牲になる可能性がある
専門プロバイダー:
- 特定の分野において専門家レベルのコンテンツを提供する
- 広く普及する前に、最先端のトピックを取り上げる場合が多い
- 包括的な網羅性を得るには、複数のプロバイダーを組み合わせる必要がある
- 学習者コミュニティの規模が小さい場合がある
スキルアップのニーズが多岐にわたる組織では、通常、Pythonプログラミングの基礎から高度なAIブートキャンプまであらゆるものを提供する広範なプラットフォームを好む傾向があり、多様な役割に対応しつつ一元的な管理が可能となる。
評価および認定の厳格さ
検証を伴わない研修では、組織は実際のスキル習得状況について不確実性を抱くことになります。評価手法は多岐にわたります:
- 自動クイズは知識の再現力を測るが、応用力は測れない
- コーディング課題は、制約のある環境下での実装能力を検証する
- ポートフォリオプロジェクトはエンドツーエンドの能力を実証するが、主観的な審査が必要となる
- 監督付き試験は資格認定にはつながるが、実践的な能力を反映していない可能性がある
最も効果的なプログラムは、複数の評価手法を組み合わせ、学習者が概念を説明できるだけでなく、解決策を実装できることを確実にします。専門資格認定プログラムとの連携により、雇用主やクライアントにとって説得力のある外部からの評価が加わります。
学習体験とエンゲージメントツール
コンテンツの質だけでは学習成果は保証されません。提供方法こそが、知識の定着と実践に大きな影響を与えるのです。最新のAIトレーニングオンラインプラットフォームには、以下の機能が組み込まれています:
- ローカル環境のセットアップを必要とせず、実験が可能なインタラクティブなコーディング環境
- ピアラーニングやグループプロジェクトを支援するリアルタイムのコラボレーション機能
- 質問に答え、学習リソースを推奨するAI搭載の学習アシスタント
- 習得度に応じて難易度を調整する適応型カリキュラム
これらの機能は、従来の教室のような即時のサポート体制が整っていない遠隔チームや非同期学習者にとって特に有益です。学習テクノロジーへの投資こそが、プレミアムなプラットフォームと基本的な動画アーカイブとの違いを際立たせています。
オンラインAIトレーニングの分野をうまく活用するには、プログラムの特徴を学習目標、技術的バックグラウンド、組織的な制約と照らし合わせて検討する必要があります。包括的なカリキュラム、実践的な実装プロジェクト、柔軟な提供モデルが融合した2026年は、専門家や組織が競争優位性を生み出すAI能力を構築するのに理想的な時期です。MammothClubは、3,000以上のオンデマンドコース、インタラクティブなブートキャンプ、およびAI駆動型学習ツールを活用した企業向け認定プログラムを通じて、トレーニングを測定可能かつ結果重視のものにし、こうしたニーズに対応しています。 最先端のAI技術を習得したい個人であれ、全社的な能力を構築しようとする組織であれ、適切なトレーニングプラットフォームは、学習を単なるコストセンターから、イノベーションと成長を促進する戦略的要素へと変革します。